O problema N+1 no JPA/Hibernate: por que sua tela lenta faz 101 consultas
Uma lista de 100 pedidos que dispara 101 SELECTs no banco. Entenda de onde vem o problema N+1, como enxergá-lo no log e como resolver com JOIN FETCH, EntityGraph, batch fetching e projeções.

5 min de leitura
Neste artigo
Quase todo mundo que trabalha com Java e banco de dados já viveu esta cena:
“A tela funciona perfeitamente no meu computador. Em produção ela leva quinze segundos para abrir.”
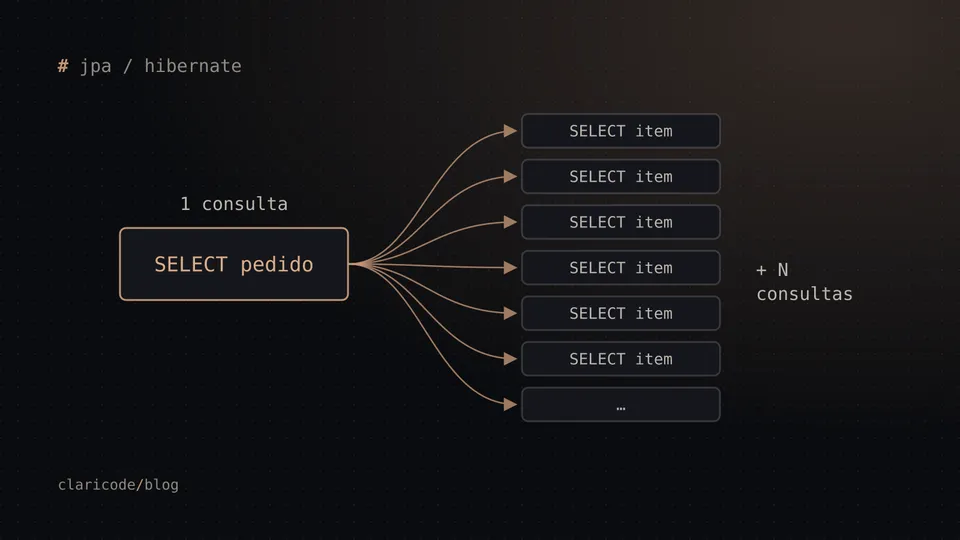
No computador do desenvolvedor, o banco tem cinco pedidos de teste. Em produção, tem milhares. E a tela, que lista os pedidos com a quantidade de itens de cada um, está disparando uma consulta para buscar os pedidos e mais uma consulta para cada pedido, só para contar os itens.
Esse é o problema N+1, provavelmente o erro de desempenho mais comum em aplicações que usam JPA/Hibernate. E o mais traiçoeiro é que o código que o causa parece perfeitamente inocente.
O cenário
Imagine duas entidades bem comuns:
@Entity
public class Pedido {
    @Id @GeneratedValue
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    private Cliente cliente;

    @OneToMany(mappedBy = "pedido")
    private List<ItemPedido> itens = new ArrayList<>();

    // getters...
}

@Entity
public class ItemPedido {
    @Id @GeneratedValue
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    private Pedido pedido;

    private String produto;
    private int quantidade;
}
Por padrão, uma coleção @OneToMany é LAZY: quando você carrega um pedido, os itens não vêm junto. O Hibernate coloca no lugar da lista um objeto “procurador” (um proxy), que só vai ao banco quando alguém de fato usar a lista.
Isso é ótimo. Imagine carregar todos os itens de todos os pedidos só para mostrar o número do pedido.
Onde nascem as N consultas
Agora o código da tela:
List<Pedido> pedidos = em.createQuery("select p from Pedido p", Pedido.class)
                         .getResultList();

for (Pedido p : pedidos) {
    System.out.println(p.getId() + ": " + p.getItens().size() + " itens");
}
Parece uma consulta só, certo? Ligue o log de SQL e veja o que realmente acontece:
select p.id, p.cliente_id from pedido p;              -- 1 consulta

select i.* from item_pedido i where i.pedido_id = 1;  -- pedido 1
select i.* from item_pedido i where i.pedido_id = 2;  -- pedido 2
select i.* from item_pedido i where i.pedido_id = 3;  -- pedido 3
-- ... uma para cada pedido
Cada p.getItens().size() acorda o proxy daquele pedido, e o proxy faz a sua própria consulta. Uma consulta para a lista + N consultas para os itens: N+1. Com 100 pedidos, 101 idas ao banco. Com 10 mil, 10.001.
E não é o banco que é lento. Cada consulta individual é rápida. O que mata é a soma das viagens: cada ida e volta pela rede custa tempo, e esse tempo é multiplicado por N.
”Então é só trocar para EAGER?”
Essa é a primeira ideia de quase todo mundo, e não resolve. FetchType.EAGER só diz que os dados devem vir junto, não diz como. Numa consulta JPQL como a acima, o Hibernate primeiro executa o seu select e depois sai buscando o que é EAGER, muitas vezes com uma consulta por registro. Você troca o N+1 que aparecia no laço por um N+1 que acontece sempre, até nas telas que nem precisam dos itens.
Inclusive, @ManyToOne é EAGER por padrão no JPA. É por isso que, no exemplo, eu marquei fetch = FetchType.LAZY explicitamente no cliente. Sem isso, a lista de pedidos já sairia fazendo uma consulta por cliente.
Como enxergar o problema
O N+1 é invisível no código e gritante no log. Em desenvolvimento, deixe sempre o SQL visível. Com Spring Boot:
spring.jpa.show-sql=true
spring.jpa.properties.hibernate.format_sql=true
A regra de bolso que eu passo para os alunos: abriu uma tela e o log rolou uma cascata de SELECTs quase iguais? É N+1. Para uma medição mais objetiva, a propriedade hibernate.generate_statistics=true mostra quantas consultas cada operação executou.
Solução 1: JOIN FETCH
A solução mais direta é dizer ao Hibernate, na própria consulta, o que você vai usar:
List<Pedido> pedidos = em.createQuery(
        "select distinct p from Pedido p left join fetch p.itens", Pedido.class)
    .getResultList();
O join fetch traz os pedidos e os itens numa consulta só, com um JOIN no banco, e já preenche as listas. O distinct evita pedidos repetidos na lista (o JOIN devolve uma linha por item). No Hibernate 6 essa duplicação já é removida automaticamente, mas o distinct não atrapalha e deixa a intenção clara.
Cuidado com a paginação. join fetch em coleção com setFirstResult/setMaxResults não pode ser paginado pelo banco, porque cada pedido ocupa várias linhas. O Hibernate então traz tudo e pagina em memória, e avisa isso no log. Se a tela é paginada, prefira as soluções 3 ou 4.
Solução 2: @EntityGraph
Se você usa Spring Data JPA e não quer escrever JPQL, o @EntityGraph faz o mesmo papel de forma declarativa:
public interface PedidoRepository extends JpaRepository<Pedido, Long> {

    @EntityGraph(attributePaths = "itens")
    List<Pedido> findAll();
}
Repare na vantagem: o mapeamento continua LAZY, e cada consulta decide o que precisa trazer junto. A tela de lista pede os itens; a tela que só mostra o número do pedido, não.
Solução 3: batch fetching
Às vezes você não controla a consulta inicial, ou precisa paginar. Aí entra o carregamento em lote:
@OneToMany(mappedBy = "pedido")
@BatchSize(size = 50)
private List<ItemPedido> itens = new ArrayList<>();
O Hibernate continua carregando os itens sob demanda, mas, quando o primeiro proxy acorda, ele aproveita a viagem e busca os itens de até 50 pedidos de uma vez, com um where pedido_id in (...). Os 100 pedidos passam a custar 1 + 2 consultas em vez de 101.
Também dá para ligar isso para o projeto inteiro com a propriedade hibernate.default_batch_fetch_size. É uma rede de proteção muito boa para sistemas que já nasceram com N+1 espalhado.
Solução 4: buscar só o que a tela mostra
A tela do nosso exemplo não precisa dos itens. Precisa da quantidade de itens. Para isso, carregar entidades é desperdício: uma projeção resolve tudo no banco.
public record ResumoPedido(Long id, long quantidadeItens) {}

List<ResumoPedido> resumo = em.createQuery("""
        select new com.loja.ResumoPedido(p.id, count(i))
        from Pedido p left join p.itens i
        group by p.id
        """, ResumoPedido.class)
    .getResultList();
Uma consulta, uma linha por pedido, nenhum proxy, nenhuma entidade gerenciada. E paginável sem restrição. Para telas de listagem e relatórios, costuma ser a solução mais rápida de todas.
Qual escolher?
| Situação | Melhor caminho |
|---|---|
| Tela usa a entidade e as coleções, sem paginação | JOIN FETCH ou @EntityGraph |
| Spring Data, sem querer escrever JPQL | @EntityGraph |
| Consulta paginada que precisa das coleções | @BatchSize / default_batch_fetch_size |
| Listagem ou relatório que mostra só alguns campos | Projeção (DTO / record) |
E uma regra que vale para todos os casos: mapeie tudo como LAZY e busque explicitamente o que cada tela usa. O mapeamento descreve o domínio; a consulta descreve a necessidade da tela. Misturar as duas coisas, colocando EAGER no mapeamento para “resolver” uma tela, é o caminho mais curto para um sistema lento por inteiro.
Conclusão
O N+1 não é defeito do Hibernate. É o resultado de usar uma ferramenta poderosa sem entender o que ela faz por baixo. O ORM esconde o SQL para você escrever menos código, não para você parar de pensar no banco.
- LAZY é o padrão saudável, mas cada acesso a um proxy pode ser uma ida ao banco;
- EAGER não resolve: só muda o lugar do problema;
JOIN FETCH,@EntityGraph,@BatchSizee projeções resolvem, cada um no seu cenário;- e o log de SQL ligado em desenvolvimento é o seu melhor amigo.
Esse tipo de decisão é o que separa quem “usa JPA” de quem domina persistência de verdade. No Intensivão JPA/Hibernate eu cubro o ciclo de vida do EntityManager, as estratégias de carregamento e as consultas eficientes com esse mesmo cuidado. Mas, com ou sem curso, leve uma coisa daqui: programar é um ato de pensar, inclusive no que acontece do outro lado da conexão com o banco.