Vetor ou lista encadeada? O que muda de verdade na memória
Acessar por posição, inserir no meio, gastar memória: entenda, com C++ e desenhos, quando o vetor ganha da lista encadeada, quando perde, e por que a resposta da prova nem sempre é a do mundo real.

6 min de leitura
Neste artigo
- Como cada uma mora na memória
- O vetor: um bloco só, lado a lado
- A lista encadeada: nós espalhados, ligados por ponteiros
- Acessar a posição i
- Inserir no começo ou no meio
- No vetor, alguém precisa sair do lugar
- Na lista, só as setas mudam
- Remover
- O resumo que cai na prova
- A parte que a prova não conta: o cache
- Então, quando usar lista encadeada?
- Veja acontecendo
- Conclusão
Todo semestre, na primeira semana de Estruturas de Dados, alguém levanta a mão e pergunta:
“Professor, qual é melhor: vetor ou lista encadeada?”
E todo semestre eu respondo a mesma coisa: depende. Só que “depende” sozinho não ensina nada. A pergunta boa é: depende de quê?
A resposta está num lugar que muita gente pula quando aprende a programar: a memória do computador. Quem entende como cada estrutura mora na memória nunca mais precisa decorar tabela de complexidade. Ela sai sozinha, de cabeça.
Então vamos com calma, desenhando.
Como cada uma mora na memória
O vetor: um bloco só, lado a lado
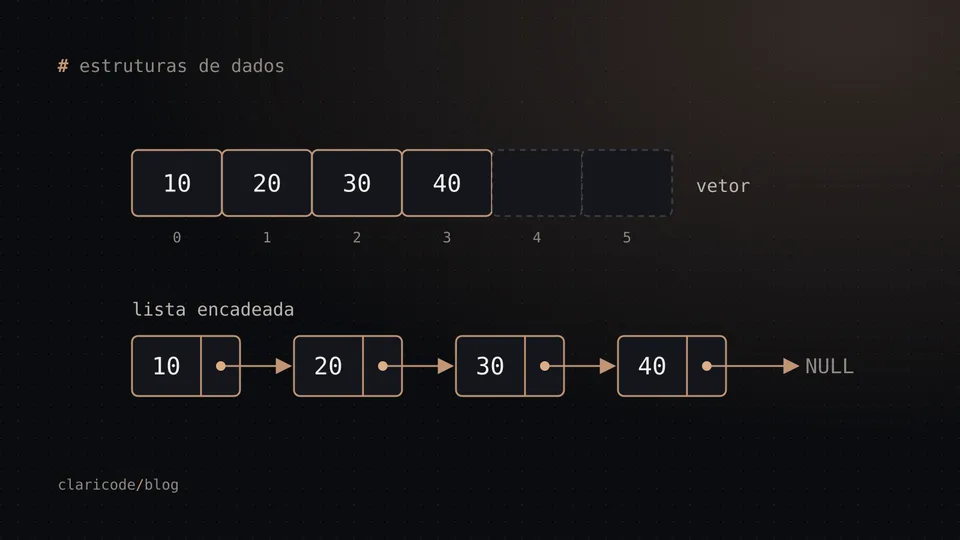
Quando você declara um vetor (ou lista contígua), o sistema reserva um bloco único de memória, com os elementos encostados um no outro:
int v[6] = {10, 20, 30, 40};Se cada int ocupa 4 bytes e o vetor começa no endereço 1000, então v[0] está em 1000, v[1] em 1004, v[2] em 1008, e assim por diante. Repare na regra:
endereço de v[i] = endereço inicial + i × tamanho do elementoEssa conta é uma multiplicação e uma soma. Não importa se você quer o elemento 3 ou o elemento 3 milhões: o custo é o mesmo. É por isso que se diz que o acesso por posição no vetor é O(1), tempo constante.
A lista encadeada: nós espalhados, ligados por ponteiros
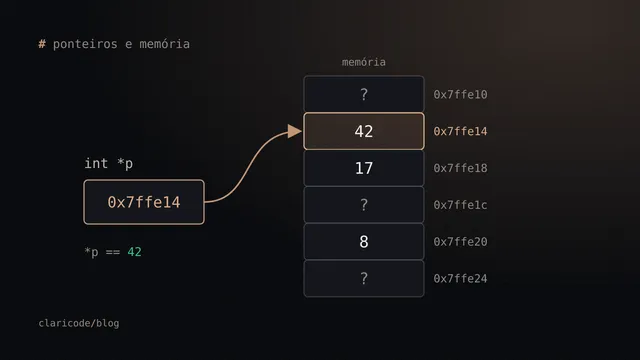
Na lista encadeada, cada elemento mora num nó separado, criado com new em qualquer lugar livre da memória. Para não se perderem, os nós guardam o endereço do próximo:
struct No {
    int item;
    No* prox;   // endereço do próximo nó (ou NULL no último)
};
A lista em si só conhece o primeiro nó, o head. O resto ela descobre seguindo as setas, uma de cada vez.
Aqui está a diferença fundamental, e todo o resto deste artigo é consequência dela: o vetor sabe onde está cada elemento; a lista só sabe onde está o primeiro.
Acessar a posição i
No vetor, já vimos: uma conta e pronto.
Na lista, não existe conta possível, porque os nós não seguem nenhuma ordem na memória. A única saída é começar no head e caminhar:
No* getElemento(int n) {
    No* p = head;
    int i = 0;
    while (p != NULL && i < n) {
        p = p->prox;   // pula para o próximo nó
        i++;
    }
    return p;
}
Para chegar na posição 1000, são 1000 pulos. O custo cresce junto com a posição: O(n).
Se a sua aplicação vive de lista[i], a lista encadeada já perdeu a disputa.
Inserir no começo ou no meio
Agora o jogo vira.
No vetor, alguém precisa sair do lugar
Para inserir o 15 na posição 1 do vetor 10, 20, 30, 40, não dá para “abrir espaço” do nada. Os elementos da posição 1 em diante precisam andar uma casa para a direita, de trás para frente, para não sobrescrever ninguém:
void shiftEnd(int posicao) {
    for (int i = quant; i > posicao; i--) {
        v[i] = v[i - 1];
    }
}

void insert(int posicao, int novo) {
    shiftEnd(posicao);
    v[posicao] = novo;
    quant++;
}
Inserir no começo de um vetor com 1 milhão de elementos significa 1 milhão de cópias. É O(n). E se o vetor estiver cheio, ainda tem que alocar um bloco maior e copiar tudo para lá.
Na lista, só as setas mudam
Na lista, ninguém sai do lugar. Você cria o nó novo e religa dois ponteiros:
void insereNoInicio(int novo) {
    No* n = new No;
    n->item = novo;
    n->prox = head;   // o novo aponta para quem era o primeiro
    head = n;         // e passa a ser o primeiro
}
Duas atribuições, não importa o tamanho da lista. O(1).
Mas atenção para a pegadinha que derruba muito aluno na prova: inserir no meio da lista só é O(1) se você já tem o ponteiro para o nó anterior. Se tem só a posição, precisa primeiro andar até lá com o getElemento, e aí voltamos ao O(n).
Remover
A lógica é a mesma da inserção, invertida:
- Vetor: remover da posição 0 obriga todo mundo a andar uma casa para a esquerda (
shiftFront). O(n). - Lista: remover o primeiro é fazer
head = head->proxe dardeleteno nó que saiu. O(1). No meio, de novo, depende de já ter o anterior em mãos.
O resumo que cai na prova
| Operação | Vetor | Lista encadeada |
|---|---|---|
| Acessar a posição i | O(1) | O(n) |
| Inserir/remover no fim | O(1)* | O(n) sem ponteiro para o fim |
| Inserir/remover no início | O(n) | O(1) |
| Inserir/remover no meio | O(n) | O(1) se já tem o nó anterior |
| Memória extra | nenhuma por elemento | um ponteiro por nó (dois na dupla) |
* Enquanto houver espaço. Quando enche, um vetor dinâmico realoca e copia tudo, mas isso acontece raramente o suficiente para o custo médio continuar constante.
A parte que a prova não conta: o cache
Até aqui, a lista parece vencer em tudo que envolve inserir e remover. Na teoria, vence mesmo. Na prática, a história tem um capítulo a mais.
O processador não busca da memória um byte por vez. Ele traz blocos inteiros para o cache, uma memória pequena e muito mais rápida. Quando você percorre um vetor, o próximo elemento quase sempre já veio junto no bloco anterior. O processador praticamente adivinha o que você vai pedir.
Na lista, cada nó pode estar em qualquer canto da memória. Cada p = p->prox corre o risco de ser uma ida até a memória principal, que é dezenas de vezes mais lenta que o cache.
O resultado surpreende muita gente: para quantidades moderadas de dados, um std::vector costuma ser mais rápido que um std::list até em inserções no meio. Deslocar elementos contíguos é uma operação que o hardware faz muito bem; perseguir ponteiros espalhados, não.
Isso não torna a análise assintótica inútil. Ela continua mandando quando o n cresce de verdade. Mas mostra por que entender a máquina vale mais do que decorar a tabela.
Então, quando usar lista encadeada?
Ela continua sendo a escolha certa em vários cenários:
- Muitas inserções e remoções em pontos que você já tem em mãos, como uma fila de processos em que cada processo guarda o ponteiro para o próprio nó.
- Quando você não pode invalidar referências. Num vetor que realoca, todo ponteiro para os elementos antigos fica inválido. Na lista, cada nó fica onde nasceu.
- Pilhas e filas sem limite de tamanho, crescendo nó a nó, sem nunca precisar copiar tudo para um bloco maior.
- Como peça de outras estruturas: tabelas hash com encadeamento, listas de adjacência de grafos, o sistema de alocação de memória do próprio sistema operacional.
E o vetor ganha quando o padrão é ler muito, acessar por posição e percorrer em ordem, que, sendo honesto, é a maior parte dos programas do dia a dia.
Veja acontecendo
Ler sobre ponteiro e deslocamento ajuda. Ver, ajuda muito mais. Na ferramenta gratuita de Estruturas de Dados você insere e remove numa lista contígua, numa encadeada simples e numa duplamente encadeada, e acompanha cada passo com o código C++ ao lado: o shiftEnd copiando casa por casa, o nó novo esperando fora da lista até ser ligado, o delete do nó que saiu. Tem até uma visão com os endereços de memória, para você ver o que as setas realmente guardam.
Faça o teste: insira no início de um vetor de 10 posições e depois numa lista encadeada. Conte quantos passos cada uma dá. Você nunca mais esquece.
Conclusão
Não existe estrutura melhor. Existe a estrutura certa para o padrão de uso do seu problema:
- precisa de acesso por posição e percursos rápidos? Vetor;
- precisa inserir e remover em pontos que você já conhece, sem mover ninguém? Lista encadeada.
E na dúvida, meça. Como sempre digo em sala, programar é um ato de pensar. E pensar, aqui, é saber o que acontece na memória quando a sua linha de código roda.